Sebagian besar dokumen yang membuat sebuah perusahaan berjalan bukanlah pekerjaan kreatif. Laporan progres, ringkasan kontrak, bahan rapat direksi: semuanya dirakit dari hal-hal yang sudah diketahui organisasi, oleh orang yang tahu harus mencari ke mana. Pengetahuan itulah aset yang sebenarnya, dan sebagian besar terjebak di kepala orang dan di dalam folder. Spead AI, perusahaan yang saya dirikan pada November 2025, ada untuk mengubahnya menjadi sesuatu yang bisa dipakai oleh sistem.
Mengapa model generik gagal di dalam organisasi
Model bahasa serbaguna sudah membaca sebagian besar internet publik. Ia belum pernah membaca standar pengadaan Anda, tiga laporan kuartalan terakhir, atau klausul yang selalu diminta tim legal. Minta ia menyusun dokumen internal, dan hasilnya lancar, masuk akal, dan keliru tepat di bagian yang penting: template yang salah, istilah yang salah, angka karangan.
Fine-tuning tidak menyelesaikan ini: konteks internal berubah setiap minggu, prosesnya lambat dan mahal, dan reviewer tetap tidak punya cara melihat dari mana sebuah kalimat berasal. Di organisasi yang diregulasi atau di BUMN, paragraf yang tidak bisa ditelusuri ke dokumen sumber tidak boleh masuk ke laporan.
Apa yang dikerjakan engine RAG kontekstual
Retrieval-Augmented Generation adalah jawaban praktisnya: biarkan model tetap generik, lalu sodorkan dokumen milik organisasi tepat pada saat menulis. Engine Spead AI terdiri dari lima bagian.
- Integrasi aman dengan dokumen internal. Berkas tetap berada di lingkungan klien, diindeks mengikuti aturan akses yang sudah ada, bukan disalin ke tempat baru.
- Metadata chunking. Dokumen dipotong menjadi bagian-bagian yang membawa asal-usulnya: jenis dokumen, departemen, tanggal, versi, bab. Retrieval lalu bisa menyaring berdasarkan hal yang penting, bukan sekadar mencocokkan kata.
- Retrieval. Untuk tiap bagian dokumen, engine menarik beberapa potongan yang paling relevan dengan pertanyaannya, diurutkan berdasarkan kemiripan semantik dan disaring oleh metadata.
- Generation. Model menulis hanya dari potongan tersebut, dengan gaya bahasa organisasi, dan menyertakan rujukan ke sumbernya.
- Loop koreksi diri. Setiap bagian yang dihasilkan dinilai relevansinya terhadap konteks yang diambil. Di bawah ambang batas, engine menulis ulang kueri, mengambil ulang, dan mencoba sekali lagi.
Bagian terakhir inilah yang membedakan demo dari sesuatu yang bisa dipercaya reviewer. Berikut loop tersebut sebagai satu node LangGraph, disederhanakan agar mudah dibaca:
Node ini membaca state graf bersama (query, context, generation, score), mengambil tiga potongan terdekat dari vector store, menghasilkan jawaban, lalu meminta evaluator chain terpisah menilai seberapa kuat jawaban itu berpijak pada konteks. Di bawah relevance score 0.85, node mengembalikan fallback dan graf diarahkan kembali ke ekspansi kueri; jika tidak, hasilnya diloloskan. Ambang batas, jumlah potongan, dan prompt evaluator disetel per jenis dokumen, tetapi strukturnya persis seperti ini: ambil, hasilkan, nilai, dan menolak lanjut kalau skornya lemah.
Apa yang ditunjukkan pilot
Kami mengukur engine ini pada dokumen pelaporan bernilai tinggi dengan satu mitra pilot. Secara manual, satu dokumen semacam itu memakan sekitar lima jam waktu seorang spesialis; dengan engine, dokumen yang sama selesai dalam sekitar empat puluh menit, pengurangan sebesar 87%.
Hasil kedua sama pentingnya. Karena setiap angka berasal dari potongan yang diambil, bukan dari ingatan atau ketik ulang, kesalahan manusia dalam pelaporan korporat menjadi lebih sedikit, sehingga reviewer bisa memeriksa penilaian alih-alih memburu angka yang tertukar. Saya tidak menyebut nama mitranya; intinya ada pada alur kerjanya, dan alur kerja itu bisa dipindahkan.
Ekonomi keahlian
Saya menyebut gagasan dasarnya ekonomi keahlian, the expertise economy. Di kebanyakan organisasi, keahlian dikonsumsi sekali pakai: orang senior menjawab pertanyaan atau membetulkan laporan, dan nilainya hilang begitu berkasnya ditutup. Engine RAG kontekstual mengubah keahlian itu menjadi aset digital yang bisa dipakai ulang. Template yang disetujui, keputusan masa lalu, cara sebuah departemen merumuskan risiko: semuanya menjadi bisa ditemukan dan dirangkai, sehingga dokumen berikutnya bermula dari apa yang sudah diketahui organisasi.
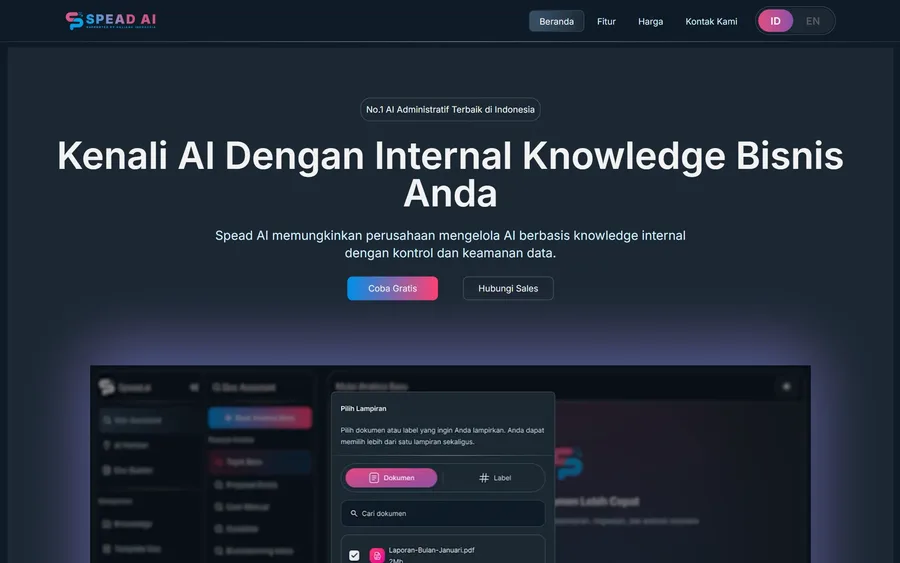
Spesialis berhenti menjadi hambatan untuk setiap dokumen rutin dan berubah menjadi reviewer sekaligus sumber pengetahuan baru. Yang dimiliki perusahaan pun berubah: bukan sebuah model, yang menua, melainkan kumpulan konteks yang terkelola dan terus bertambah nilainya. Spead AI mengemasnya menjadi lima modul di spead.ai: Doc Assistant, Doc Builder, Daily Productivity Planner, AI Partner, dan Enterprise Admin Panel.
Bagaimana enterprise atau BUMN bisa mulai
Kalau Anda berada di perusahaan besar atau BUMN dan ingin menguji ini, saya menyarankan empat langkah.
- Lakukan inventaris data. Daftar sumber dokumen yang akan dibaca engine, siapa pemiliknya, seberapa sensitif, dan di mana tersimpan. Sebagian besar pekerjaan proyek RAG ada di sini, dan hasilnya tetap Anda pegang apa pun vendornya.
- Pilih satu jenis dokumen bernilai tinggi. Cari yang berulang, memakan waktu, dan sebagian besar dirakit dari bahan yang sudah ada, misalnya laporan bulanan atau ringkasan tender: yang paling repetitif, bukan yang paling sulit.
- Tulis rubrik evaluasi sebelum membangun. Tentukan keluaran yang baik: angka benar, template benar, setiap klaim bisa ditelusuri ke sumber, nada tulisan tepat. Nilai dulu proses manual saat ini dengan rubrik itu supaya ada garis dasar.
- Pertahankan manusia dalam review. Tugas engine adalah membuat reviewer lebih cepat dan kesalahan lebih jarang, bukan menghapus reviewer. Tidak ada yang keluar tanpa persetujuan, dan setiap perubahan reviewer dicatat; catatan itu adalah sinyal perbaikan berikutnya.
Dengan cara ini, pilot pertama memakan hitungan minggu, bukan kuartal, dan hasilnya adalah angka yang bisa dibaca direksi.
Selanjutnya: kalau ada jenis dokumen di organisasi Anda yang cocok dengan pola ini, hubungi saya.
Pertanyaan yang sering diajukan
- Retrieval-augmented generation yang menaruh dokumen milik organisasi di depan model umum saat menulis, disaring dengan metadata dan diperiksa loop koreksi diri, sehingga setiap klaim bisa dilacak ke sumbernya.
- Laporan bernilai tinggi yang dikerjakan spesialis sekitar lima jam secara manual selesai sekitar empat puluh menit dengan engine ini, 87% lebih cepat, dengan kesalahan manusia yang lebih sedikit.
- Inventarisasi sumber data, pilih satu jenis dokumen berulang yang bernilai tinggi, tulis rubrik evaluasi dan ukur kondisi awal sebelum membangun, dan tetap libatkan reviewer manusia.